🧪 VelsTech Lab Spark-X2.5 4B एकदम नया 4.1B architecture है – इतना नया कि मेरे llama.cpp build ने इसे लोड करने से ही मना कर दिया (unknown model architecture: 'spark2_5')। अपडेट और rebuild के बाद मैंने RX 6800M पर तीनों quants – BF16, Q8_0 और Q4_K_M – को साथ-साथ चलाया। नतीजा आम "छोटा मतलब तेज़" कहानी नहीं है: Q8_0 prompt processing जीतता है, Q4_K_M generation जीतता है, और full-precision BF16 दोनों से एक quality task हार जाता है।
LLM VRAM Calculator – क्या आपकी VRAM में weights + आपका context फिट होगा? · GPU AI Performance Calculator – चलाने से पहले कितने tok/s मिलेंगे, अनुमान लगाएँ।
कैलकुलेटर खोलें →नीचे हर नंबर – throughput, VRAM, GPU/CPU utilisation, temperature, power और context-fit अनुमान – benchscope से लिया गया है, एक llama-bench wrapper जिसे मैंने खास ऐसे टेस्ट के लिए बनाया है। MIT licensed, जहाँ llama-bench चले वहाँ चले।
GitHub पर benchscope →टेस्ट मशीन
- मशीन: ASUS ROG Strix G513QY · Ryzen 9 5900HX (8C/16T) · AMD RX 6800M 12GB (RDNA2, mobile) · 32 GB RAM · 2 TB NVMe
- OS: Ubuntu 26.04.1 LTS (Wayland) · ROCm · llama.cpp को current master से
spark2_5support के लिए rebuild किया गया (flags और benchmark reading के लिए llama.cpp guide देखें),n_threads=8 - मॉडल:
Spark-X2.5-4B.gguf(BF16, 7.66 GiB) ·Spark-X2.5-4B-Q8_0.gguf(4.07 GiB) ·Spark-X2.5-4B-Q4_K_M.gguf(2.42 GiB) – 4.1B params, 36 layers, 1M native context - हर run: full GPU offload,
-p 512 -n 128 -r 3, f16 KV cache, हर test के लिए अलग bench process ताकि prompt और decode को isolated telemetry मिले
कैसे चलाया
python3 benchscope.py --per-test \
  --llama-bench-bin ./build/bin/llama-bench \
  --out-json bench.json --timeseries bench.csv --out-png bench.png -- \
  -m ~/models/Spark-X2.5-4B-Q4_K_M.gguf -p 512 -n 128 -r 3
तीनों files के लिए एक ही command, सिर्फ -m बदलता है। (benchscope ROCm library path खुद सेट करता है, इसलिए LD_LIBRARY_PATH export का झंझट नहीं।)
नतीजे
Metric               BF16              Q8_0              Q4_K_M
──────────────────────────────────────────────────────────────────
Prompt eval          474.4 ± 16.6 t/s  2148.7 ± 214.9 t/s 1510.6 ± 102.9 t/s
Decode (tg)          39.1 ± 0.2 t/s    67.4 ± 0.5 t/s     98.5 ± 1.4 t/s
Context fit (est.)   101,673 tok       206,244 tok       254,389 tok
VRAM used            8461 / 12272 MiB  4736 / 12272 MiB  3041 / 12272 MiB
GPU util avg         82–89%            64–85%            66–82%
Temp max             62 °C             57 °C             53 °C
Power avg (decode)   120.7 W           101.5 W           116.0 W
मुख्य बात: कोई एक winner नहीं है। Q8_0 prompt processing का बादशाह है (BF16 का 4.5×) – पर run-to-run variance (±215 tok/s) चिंता की बात है, भरोसा करने से पहले दोबारा टेस्ट करें। Q4_K_M decoding का बादशाह है (BF16 का 2.5×) और सबसे बड़ा context budget (254K vs 101K) 3 GB से कम VRAM में लेकर चलता है। BF16 हर जगह तीसरे नंबर पर है और सबसे ज़्यादा गर्म चलता है। सरप्राइज़ यह है कि Q4 से Q8 की तरफ quantize up करने पर prompt speed मिलती है पर decode speed घटती है – prompt eval compute-bound है (dequant खर्च मायने रखता है) जबकि decode bandwidth-bound है (प्रति weight bytes मायने रखते हैं)।
प्रूफ – run cards
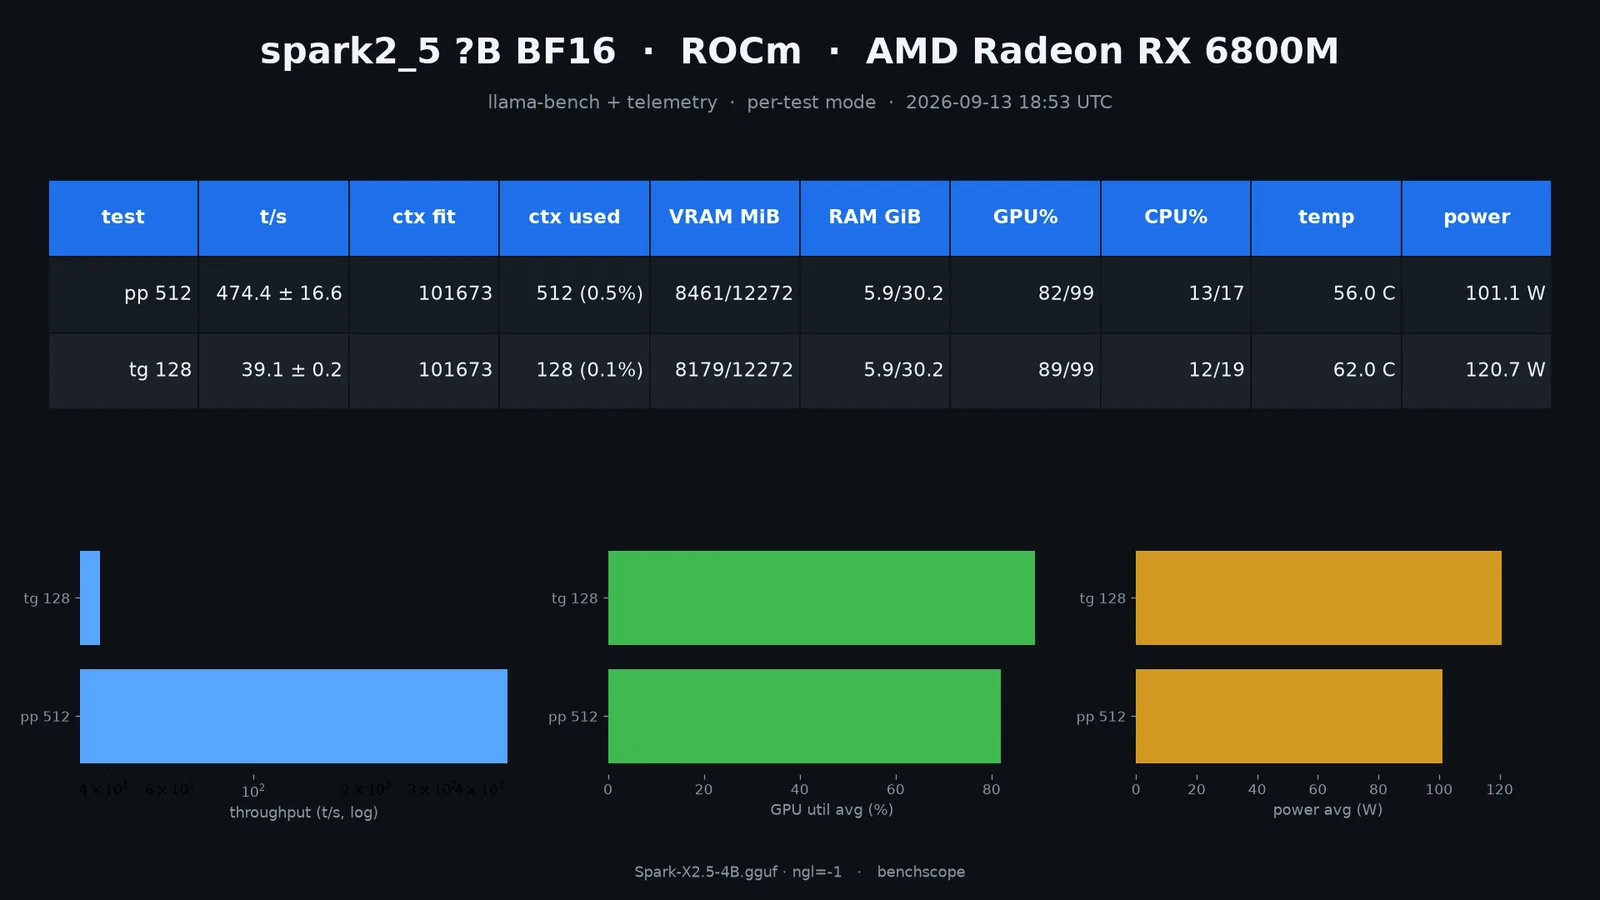
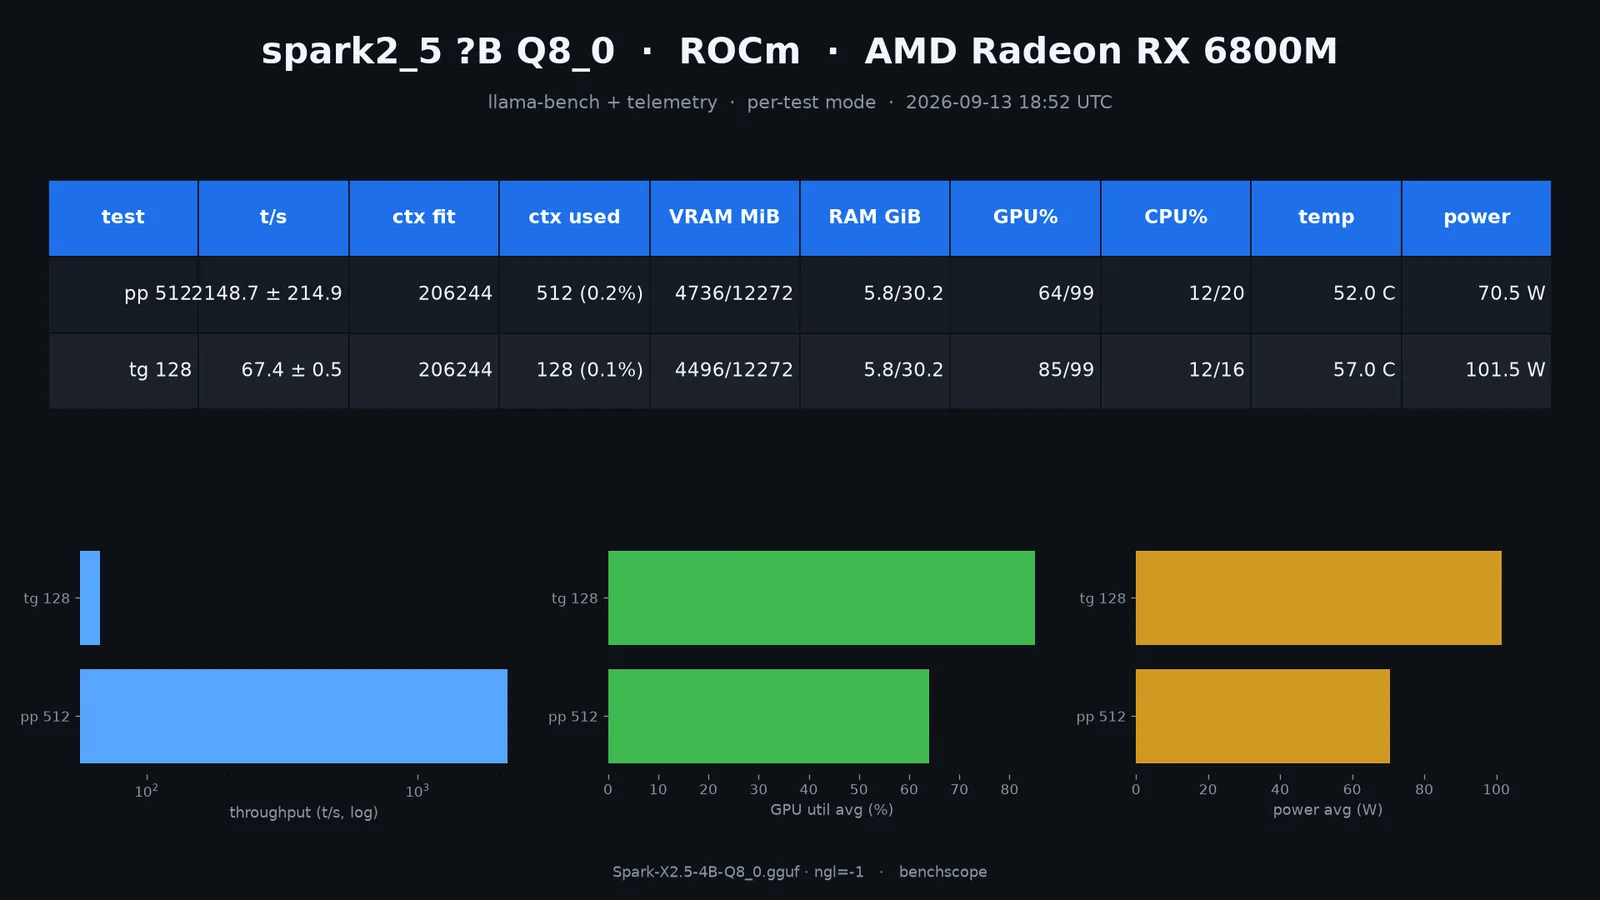
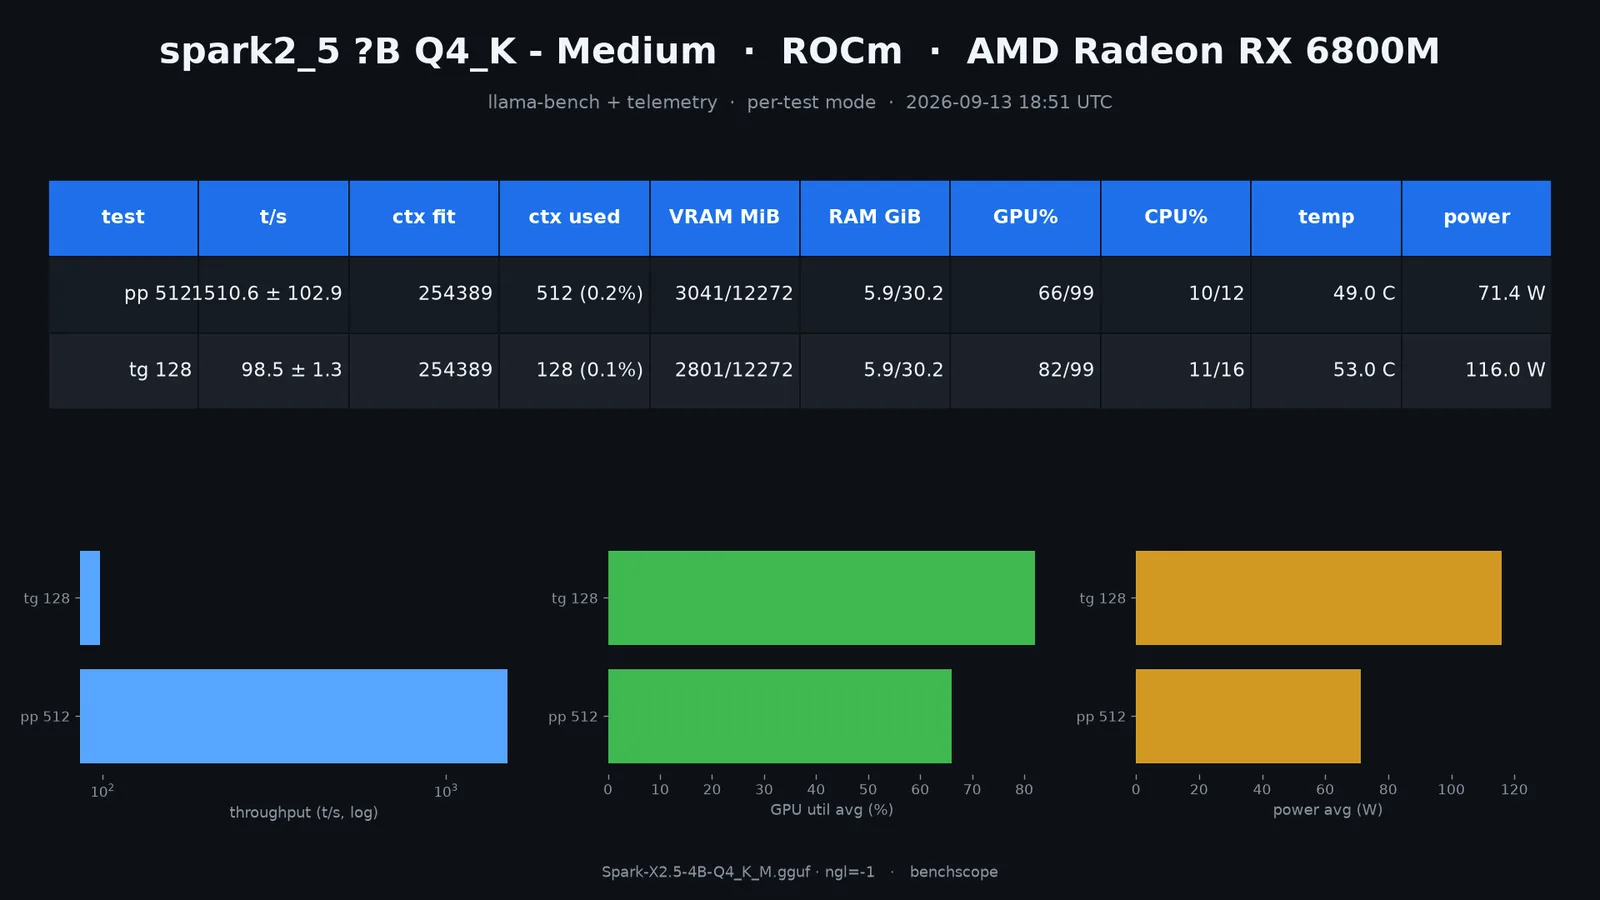
Quality check – एक tough prompt, तीनों quants
Speed सिर्फ आधी कहानी है, इसलिए तीनों को एक ही मुश्किल prompt का सामना करना पड़ा (greedy decoding, seed 42, reproducible): exact-answer format के साथ multi-step wattage calculation, strict schema वाला records-to-JSON transform, और sorted() पर बैन के साथ scratch से लिखा median() function। हर output चलाकर check किया गया, आँखों से नहीं।
Quality              BF16     Q8_0     Q4_K_M
─────────────────────────────────────────────────
Math ($9.46)         PASS     PASS*    PASS
Exact JSON           FAIL     PASS     PASS
Code runs (5.5)      PASS     PASS     PASS
Generation speed     36 t/s   59 t/s   82 t/s
मुख्य बात: BF16 – "सबसे अच्छा" quant – अकेला है जो JSON transform कभी emit ही नहीं करता, जबकि Q4_K_M हर task में उसके बराबर है, दोगुनी से ज़्यादा speed पर। दो ईमानदार caveats: जानबूझकर contradictory "output ONLY" instructions हर quant को लंबा सोचने पर मजबूर करते हैं (1024 tokens में कोई finish नहीं करता – ऐसे टेस्ट के लिए 4096 का budget रखें), और Q4 का code .sort() method पर टिका है, जो बैन के अक्षर का पालन करता है, भावना का नहीं। सही-सही कहें तो Q8_0 का $9.46 कभी अकेली line पर नहीं आता – वह "So final answer: ANSWER: $9.46" लिखता है – इसलिए उसके math PASS पर format का asterisk है।
रास्ते में क्या टूटा
unknown model architecture: 'spark2_5'– मेरा llama.cpp checkout इस architecture से पुराना था। Fix:git fetch+ upstream#27868(Spark2_5 support) वाले build पर fast-forward, फिरcmake --build build --target llama-bench llama-cli -j16। Reconfigure की ज़रूरत नहीं।libhipblas.so.3: cannot open shared object file–/opt/rocm/libloader path पर नहीं है। WorkaroundLD_LIBRARY_PATHexport है; benchscope अब इसे bench subprocess में खुद inject करता है।- Verbose reasoning – यह model family जवाब से पहले लंबा सोचता है, इसलिए quality runs के लिए
-nका generous budget रखें, चाहे जवाब छोटा ही क्यों न हो।
परिशिष्ट – इस मशीन पर exact build
पूरी जानकारी के लिए, ऊपर हर नंबर इसी ROCm build से आया है (ROCm 7.15, CMake 4.2.3 – सिर्फ gfx1031 यानी RX 6800M को target किया, जिससे compile time काबू में रहता है):
git fetch origin master && git merge --ff-only origin/master
# 5f436dddb – first build with spark2_5 support (upstream #27868)
cmake -B build -DCMAKE_BUILD_TYPE=Release \
  -DGGML_HIP=ON -DGPU_TARGETS=gfx1031 -DBUILD_SHARED_LIBS=ON
cmake --build build --target llama-bench llama-cli -j16
Benchmarking से पहले नई architecture load होती है, यह sanity-check करें:
export LD_LIBRARY_PATH=/opt/rocm/lib:$LD_LIBRARY_PATH
./build/bin/llama-bench -m ~/models/Spark-X2.5-4B.gguf -p 64 -n 0 -r 1 -o json
अगर unknown model architecture दिखे, तो आपका checkout model से पुराना है – पहले update करें, फिर rebuild। (benchscope ROCm library path को bench subprocess में खुद inject करता है, इसलिए रोज़ के runs में export की ज़रूरत नहीं।)
आख़िरी बात
12 GB RX 6800M पर Spark-X2.5 का Q4_K_M ही चलाने वाला quant है: ~98 tok/s decode, 254K-token context budget, 53 °C, और full precision जैसी quality। Q8_0 तभी चुनें जब आपका workload prompt-heavy हो और variance बर्दाश्त हो। BF16 छोड़ दें, जब तक bit-exact weights न चाहिए हों – 3× VRAM की कीमत पर तीसरा स्थान, और मेरे टेस्ट में एक formatting task भी हारा जो दोनों quants ने पास किया। पूरा method, telemetry और मापने वाला tool: GitHub पर benchscope →
संबंधित: LLM के लिए कितनी VRAM चाहिए? · Quantization deep dive · इसी कार्ड पर Qwen3.8 27B quants।
VelsTech Lab पर वापस →