🧪 VelsTech Lab Spark-X2.5 4B முற்றிலும் புதிய 4.1B architecture – என் llama.cpp build அதை load செய்ய மறுத்த அளவுக்கு புதியது (unknown model architecture: 'spark2_5'). Update + rebuild-க்குப் பிறகு RX 6800M-ல் மூன்று quants – BF16, Q8_0, Q4_K_M – ஐ பக்கத்துக்குப் பக்கமாக ஓடவிட்டேன். முடிவு வழக்கமான "சிறியது என்றால் வேகம்" கதை அல்ல: Q8_0 prompt processing-ஐ வெல்கிறது, Q4_K_M generation-ஐ வெல்கிறது, full-precision BF16 இரண்டிடமும் ஒரு quality task-ஐ தோற்கிறது।
LLM VRAM Calculator – உங்கள் VRAM-ல் weights + context பொருந்துமா? · GPU AI Performance Calculator – ஓடவிடும் முன் எத்தனை tok/s என மதிப்பிடுங்கள்.
கால்குலேட்டரை திற →கீழே உள்ள ஒவ்வொரு எண்ணும் – throughput, VRAM, GPU/CPU utilisation, temperature, power, context-fit மதிப்பீடு – benchscope மூலம் பெறப்பட்டது; இதுபோன்ற சோதனைகளுக்காக நான் உருவாக்கிய llama-bench wrapper. MIT licensed, llama-bench எங்கு ஓடுமோ அங்கு ஓடும்.
GitHub-ல் benchscope →சோதனை கணினி
- கணினி: ASUS ROG Strix G513QY · Ryzen 9 5900HX (8C/16T) · AMD RX 6800M 12GB (RDNA2, mobile) · 32 GB RAM · 2 TB NVMe
- OS: Ubuntu 26.04.1 LTS (Wayland) · ROCm · llama.cpp-ஐ current master-லிருந்து
spark2_5ஆதரவுக்காக rebuild செய்தது (flags மற்றும் benchmark வாசிப்புக்கு llama.cpp guide பார்க்கவும்),n_threads=8 - மாடல்கள்:
Spark-X2.5-4B.gguf(BF16, 7.66 GiB) ·Spark-X2.5-4B-Q8_0.gguf(4.07 GiB) ·Spark-X2.5-4B-Q4_K_M.gguf(2.42 GiB) – 4.1B params, 36 layers, 1M native context - ஒவ்வொரு ஓட்டமும்: முழு GPU offload,
-p 512 -n 128 -r 3, f16 KV cache, prompt + decode-க்கு தனி telemetry கிடைக்க ஒவ்வொரு test-க்கும் தனி bench process
எப்படி இயக்கினேன்
python3 benchscope.py --per-test \
  --llama-bench-bin ./build/bin/llama-bench \
  --out-json bench.json --timeseries bench.csv --out-png bench.png -- \
  -m ~/models/Spark-X2.5-4B-Q4_K_M.gguf -p 512 -n 128 -r 3
மூன்று files-க்கும் ஒரே command, -m மட்டும் மாறும். (benchscope ROCm library path-ஐ தானே அமைக்கிறது, LD_LIBRARY_PATH export தொல்லை இல்லை.)
முடிவுகள்
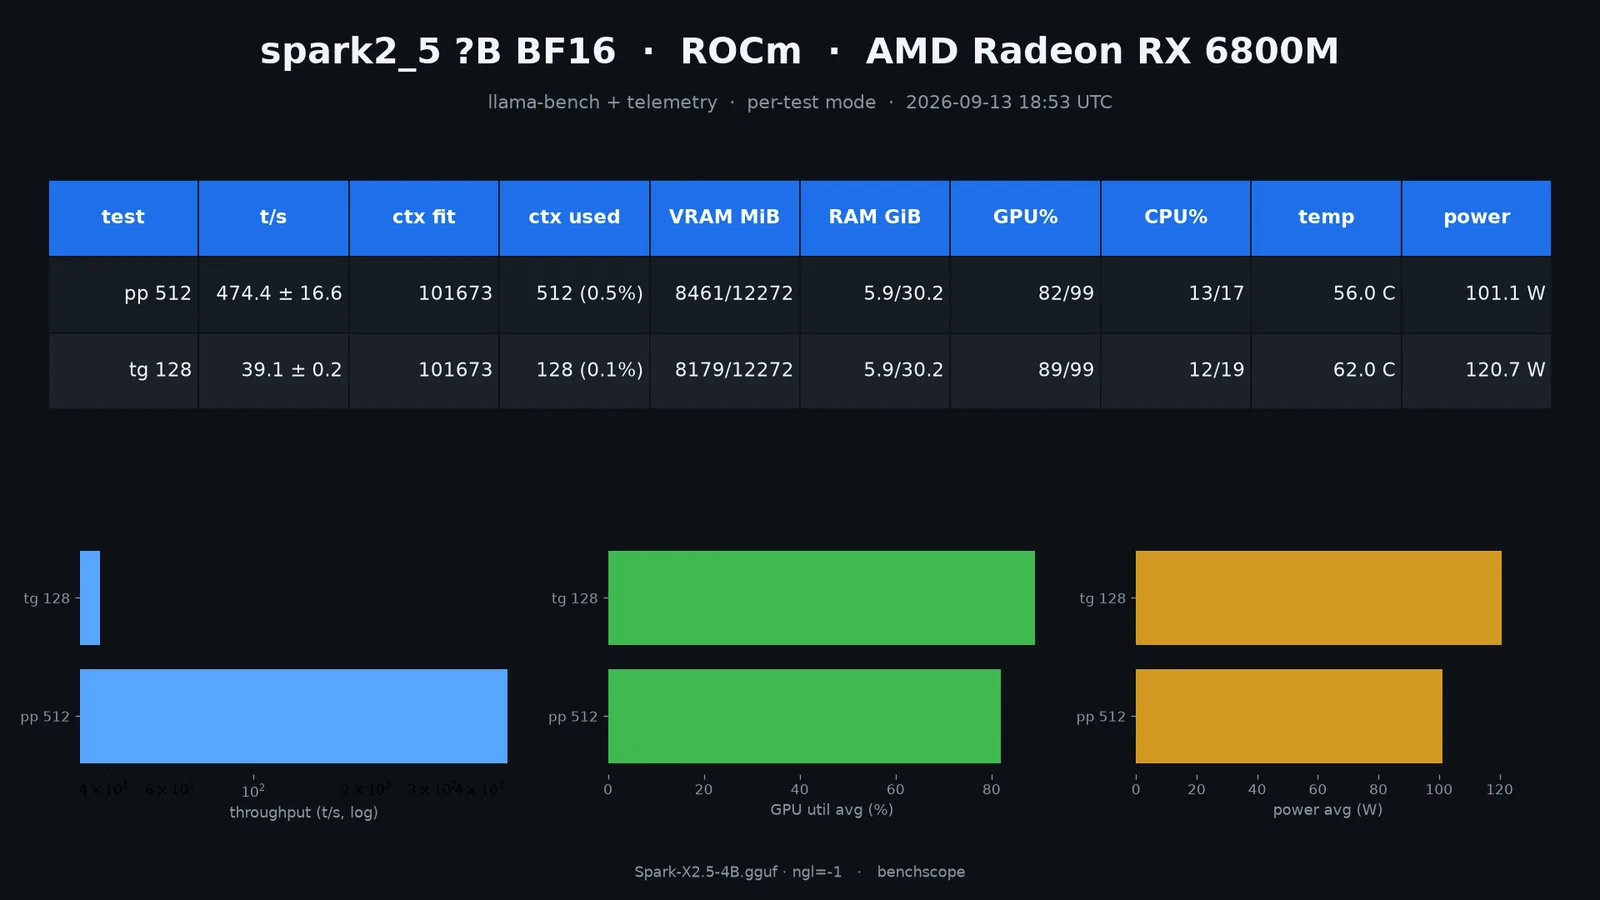
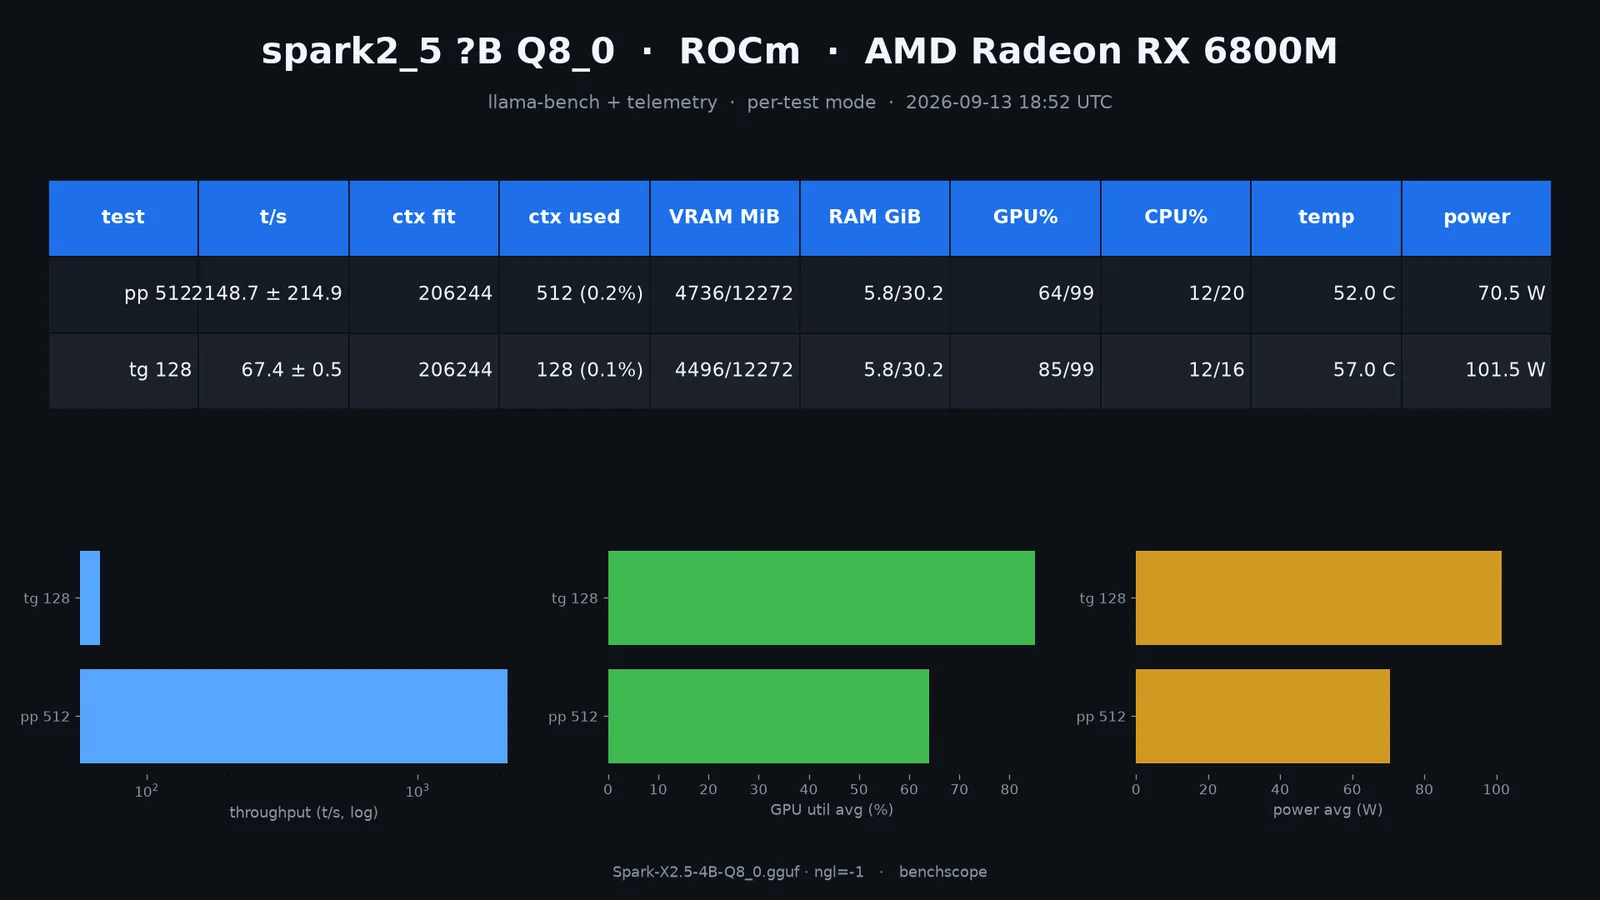
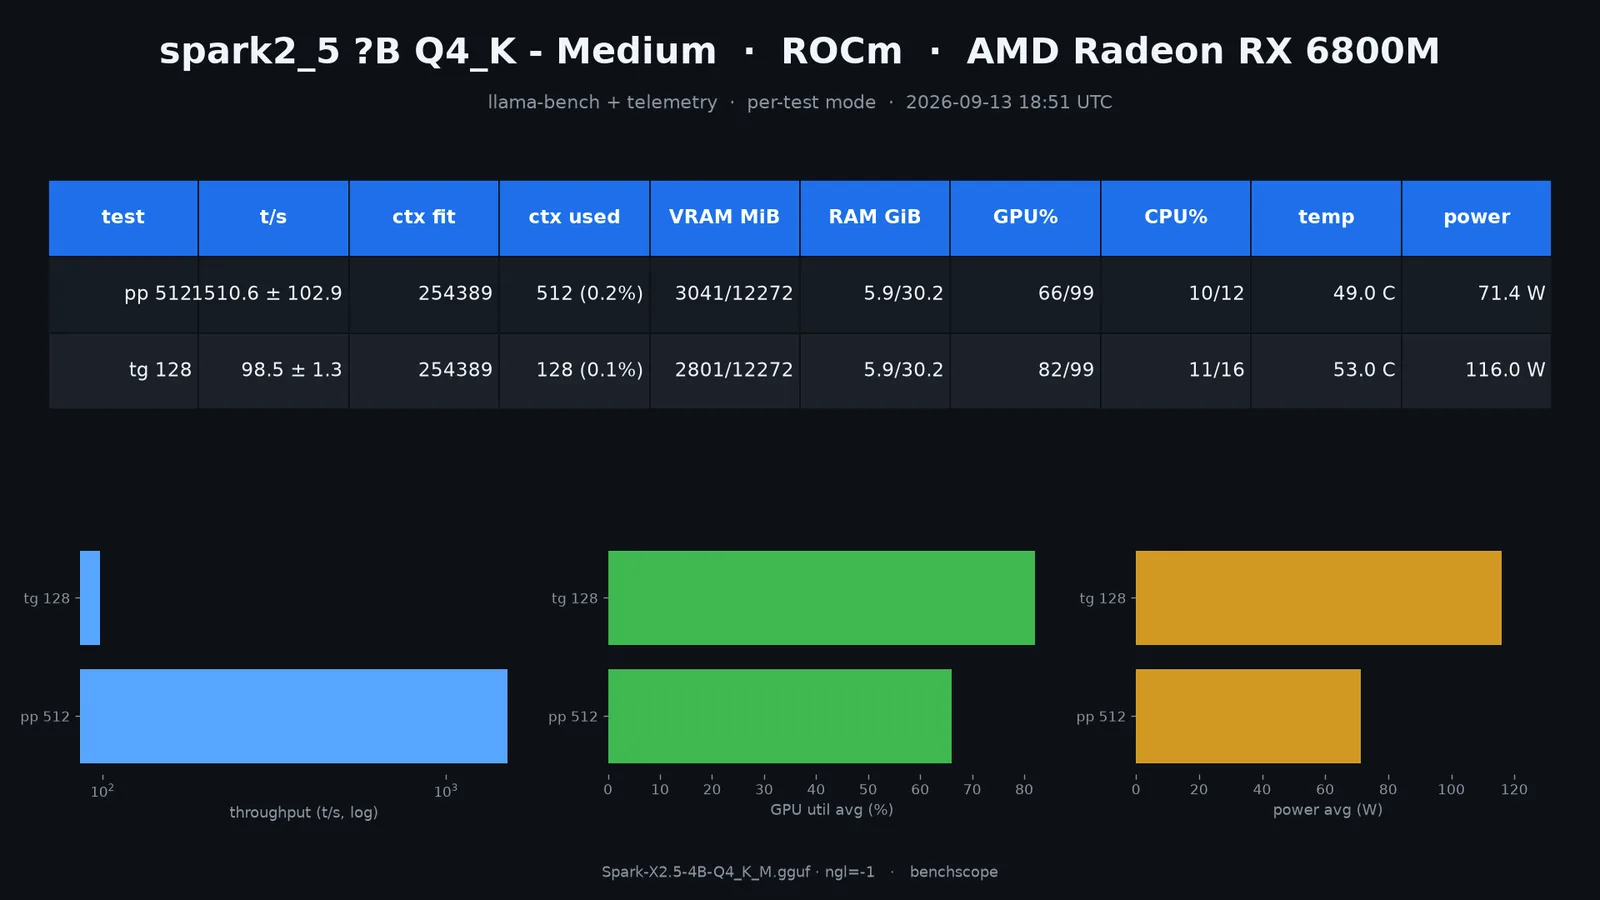
Metric               BF16              Q8_0              Q4_K_M
──────────────────────────────────────────────────────────────────
Prompt eval          474.4 ± 16.6 t/s  2148.7 ± 214.9 t/s 1510.6 ± 102.9 t/s
Decode (tg)          39.1 ± 0.2 t/s    67.4 ± 0.5 t/s     98.5 ± 1.4 t/s
Context fit (est.)   101,673 tok       206,244 tok       254,389 tok
VRAM used            8461 / 12272 MiB  4736 / 12272 MiB  3041 / 12272 MiB
GPU util avg         82–89%            64–85%            66–82%
Temp max             62 °C             57 °C             53 °C
Power avg (decode)   120.7 W           101.5 W           116.0 W
முக்கிய முடிவு: ஒரே வெற்றியாளர் இல்லை. Q8_0 prompt processing-ன் ராஜா (BF16-ஐ விட 4.5×) – ஆனால் run-to-run மாறுபாடு (±215 tok/s) கவலைக்குரியது, நம்பும் முன் மீண்டும் சோதிக்கவும். Q4_K_M decoding-ன் ராஜா (BF16-ஐ விட 2.5×), 3 GB-க்கும் குறைவான VRAM-ல் மிகப்பெரிய context budget (254K vs 101K). BF16 எல்லா இடத்திலும் மூன்றாவது, அதிக சூடு. ஆச்சரியம்: Q4-லிருந்து Q8-க்கு quantize up செய்தால் prompt வேகம் கிடைக்கிறது, decode வேகம் குறைகிறது – prompt eval compute-bound (dequant செலவு முக்கியம்), decode bandwidth-bound (ஒரு weight-க்கு bytes முக்கியம்).
ஆதாரம் – run அட்டைகள்
தர சோதனை – ஒரு கடின prompt, மூன்று quants
வேகம் பாதி கதைதான், எனவே மூன்றும் ஒரே கடினமான prompt-ஐ எதிர்கொண்டன (greedy decoding, seed 42, மீண்டும் உருவாக்கக்கூடியது): சரியான விடை வடிவத்துடன் multi-step wattage கணக்கு, strict schema-வுடன் records-to-JSON மாற்றம், sorted() தடையுடன் scratch-லிருந்து எழுதிய median() function. ஒவ்வொரு output-உம் இயக்கி சரிபார்க்கப்பட்டது, கண்ணால் அல்ல.
Quality              BF16     Q8_0     Q4_K_M
─────────────────────────────────────────────────
Math ($9.46)         PASS     PASS*    PASS
Exact JSON           FAIL     PASS     PASS
Code runs (5.5)      PASS     PASS     PASS
Generation speed     36 t/s   59 t/s   82 t/s
முக்கிய முடிவு: BF16 – "சிறந்த" quant – JSON transform-ஐ வெளியிடாத ஒரே quant, அதே நேரம் Q4_K_M ஒவ்வொரு task-இலும் அதற்கு சமம், இரு மடங்கு வேகத்தில். இரண்டு நேர்மையான caveats: வேண்டுமென்றே முரண்பட்ட "output ONLY" instructions ஒவ்வொரு quant-ஐயும் நீண்ட சிந்தனைக்கு தள்ளுகின்றன (1024 tokens-ல் எதுவும் முடிப்பதில்லை – இதுபோன்ற சோதனைகளுக்கு 4096 budget வையுங்கள்), Q4-ன் code .sort() method-ஐ நம்பியுள்ளது – தடையின் எழுத்தை மதிக்கிறது, உணர்வை அல்ல. கண்டிப்பாகச் சொன்னால், Q8_0-ன் $9.46 தனி வரியில் வருவதில்லை – "So final answer: ANSWER: $9.46" என எழுதுகிறது – எனவே அதன் math PASS-ல் வடிவமைப்புக்கான asterisk உள்ளது।
வழியில் உடைந்தவை
unknown model architecture: 'spark2_5'– என் llama.cpp checkout இந்த architecture-ஐ விட பழையது. Fix:git fetch+ upstream#27868(Spark2_5 ஆதரவு) உள்ள build-க்கு fast-forward, பிறகுcmake --build build --target llama-bench llama-cli -j16. Reconfigure தேவையில்லை.libhipblas.so.3: cannot open shared object file–/opt/rocm/libloader path-ல் இல்லை. WorkaroundLD_LIBRARY_PATHexport; benchscope இதை bench subprocess-ல் தானே செருகுகிறது.- Verbose reasoning – இந்த model family பதிலுக்கு முன் நீண்ட சிந்தனை செய்கிறது, எனவே quality ஓட்டங்களுக்கு
-n-ல் தாராள budget வையுங்கள், பதில் சிறியதாக இருந்தாலும்.
பின்னிணைப்பு – இந்த கணினியில் சரியான build
முழுமைக்காக, மேலே உள்ள ஒவ்வொரு எண்ணும் இந்த ROCm build-லிருந்து வந்தது (ROCm 7.15, CMake 4.2.3 – gfx1031 அதாவது RX 6800M-ஐ மட்டும் target, compile நேரம் கட்டுக்குள் இருக்கும்):
git fetch origin master && git merge --ff-only origin/master
# 5f436dddb – first build with spark2_5 support (upstream #27868)
cmake -B build -DCMAKE_BUILD_TYPE=Release \
  -DGGML_HIP=ON -DGPU_TARGETS=gfx1031 -DBUILD_SHARED_LIBS=ON
cmake --build build --target llama-bench llama-cli -j16
Benchmark செய்யும் முன் புதிய architecture load ஆகிறதா என சரிபார்க்கவும்:
export LD_LIBRARY_PATH=/opt/rocm/lib:$LD_LIBRARY_PATH
./build/bin/llama-bench -m ~/models/Spark-X2.5-4B.gguf -p 64 -n 0 -r 1 -o json
unknown model architecture தெரிந்தால், உங்கள் checkout model-ஐ விட பழையது – முதலில் update செய்து, பிறகு rebuild செய்க. (benchscope ROCm library path-ஐ bench subprocess-ல் தானே செருகுகிறது, தினசரி ஓட்டங்களில் export தேவையில்லை.)
இறுதி முடிவு
12 GB RX 6800M-ல் Spark-X2.5-ன் Q4_K_M தான் இயக்க வேண்டிய quant: ~98 tok/s decode, 254K-token context budget, 53 °C, full precision தரம். Q8_0-ஐ உங்கள் workload prompt-heavy-ஆக இருந்தால், மாறுபாடு பரவாயில்லை என்றால் மட்டும் தேர்வு செய்க. BF16-ஐ விடுங்கள், bit-exact weights தேவைப்பட்டால் தவிர – 3× VRAM விலையில் மூன்றாம் இடம், என் சோதனையில் இரண்டு quants pass செய்த formatting task-ஐ தோற்றது. முழு method, telemetry, அளக்கும் கருவி: GitHub-ல் benchscope →
தொடர்புடையவை: LLM-க்கு எவ்வளவு VRAM தேவை? · Quantization deep dive · இதே அட்டையில் Qwen3.8 27B quants.
VelsTech Lab-க்கு திரும்ப →