Meta Superintelligence Labs ने 12 अक्टूबर, 2026 को Muse Wonder और Muse Wonder Full रिलीज़ किए – कंपनी के पहले frontier-class मॉडल, जो personal और professional एजेंटों के लिए बनाए गए हैं: बीमा क्लेम की राह देखना, किराये के काग़ज़ात समझना, या चलने वाला ऐप बनाना। दोनों 1 मिलियन-टोकन context पर चलते हैं, इनपुट में टेक्स्ट, इमेज, वीडियो और ऑडियो लेते हैं, और Meta के गीगावाट-स्तर के Prometheus डेटासेंटर में ट्रेन हुए हैं। Muse Wonder आज ही Meta Model API और Muse Code के ज़रिए उपलब्ध है; ज़्यादा ताक़तवर Wonder Full सिर्फ़ Muse Code के पेड प्लानों में मिलता है। दोनों जल्द ही कंज़्यूमर Muse ऐप में आएँगे – सब्सक्राइबर पहले।
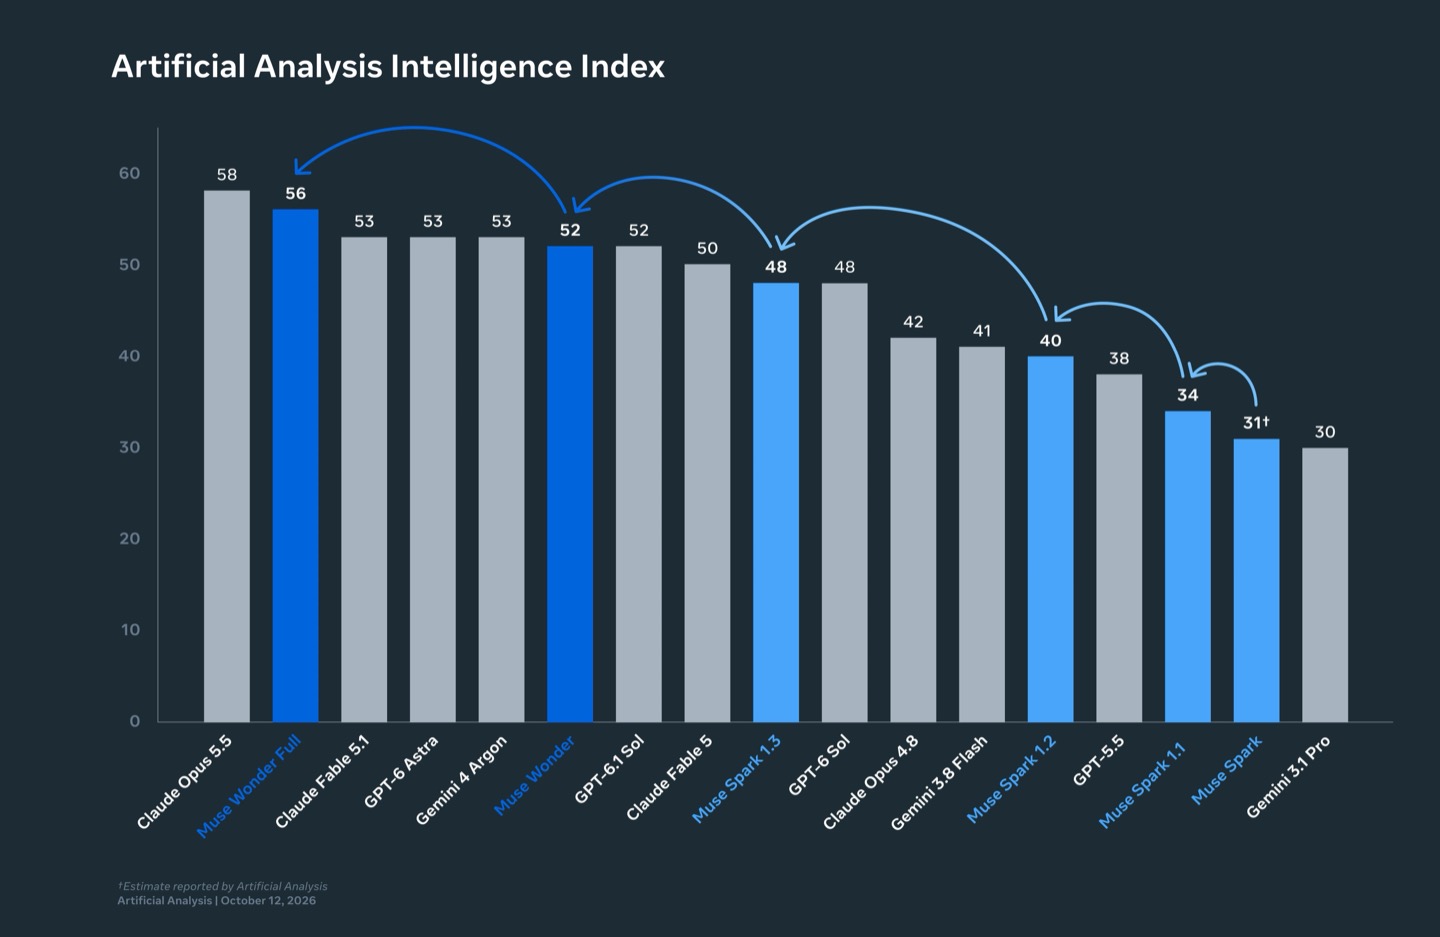
बाकी हर साइट बेंचमार्क चार्ट दोहराएगी। यहाँ वह बताया गया है जिसे वे टाल देते हैं: सबसे ताक़तवर मॉडल को आप कॉल ही नहीं कर सकते – Wonder Full सब्सक्रिप्शन-गेटेड है और सिर्फ़ Muse Code से मिलता है, इसलिए अपने कोड से सीमा साधारण Wonder की है। लॉन्च-डे इंडिपेंडेंट स्कोरिंग (Artificial Analysis) में Claude Opus 5.5 अब भी आगे है (58 बनाम Full का 56, Wonder का 52) – और साधारण Wonder उस मॉडल से बराबरी करता है जो प्रति पूरे काम छह गुना कम में चलता है। और आसान रास्ते में शर्त है: Muse Code सब्सक्रिप्शन डिफ़ॉल्ट रूप से ऐसे मोड में चलते हैं जहाँ Meta आपके प्रॉम्प्ट और कोड पर ट्रेन करता है। यही इस गाइड में कवर किया गया है।
स्रोत नोट: स्पेक्स, स्कोर और कीमतें Meta की रिसर्च घोषणा और मॉडल कार्ड (12 अक्टूबर, 2026), Meta की प्रेस रिलीज़ और Muse Code डॉक्युमेंटेशन से हैं। बेंचमार्क आँकड़े विक्रेता-रिपोर्टेड हैं – Meta के अपने शब्दों में प्रतिस्पर्धी रन "best-effort" हैं, और memory/focus टेस्ट Meta के इंटरनल हैं। इंडिपेंडेंट संदर्भ Artificial Analysis के लॉन्च-डे इंडेक्स और Claire Vo के How I AI बेंच से है। यहाँ का कोई भी आँकड़ा स्वतंत्र VelsTech Solutions बेंचमार्क नहीं है।
संबंधित: इसकी नींव हम पहले ही कवर कर चुके हैं – हमारा Muse personal-agent विस्तार (Spark 1.3, कीमत, Secure VM) और Claude Opus 5.5 का डीप-डाइव, जिससे इसकी सबसे ज़्यादा तुलना होती है।
छोटा संस्करण: 60 सेकंड में Muse Wonder
- क्या: एजेंटों के लिए Meta का frontier मॉडल परिवार – Muse Wonder (मॉडल ID muse-wonder-1.0, preview) और ज़्यादा ताक़तवर Muse Wonder Full। Muse Spark 1.3 की सीढ़ी का अगला डग; Active Memory और Active Focus के साथ लंबे personal/professional एजेंट कामों के लिए बना।
- कीमत / तारीख: 12 अक्टूबर, 2026 को रिलीज़। API: $4 प्रति मिलियन इनपुट, $0.20 कैश्ड, $20 प्रति मिलियन आउटपुट – Claude Opus 5.5 जितनी ही दरें, कोई मिनिमम स्पेंड नहीं, लंबे context का प्रीमियम नहीं। Muse Code प्लान: $5 / $50 / $200 मासिक; Full सिर्फ़ $50 और $200 टियरों पर।
- स्पेक्स: 1,048,576-टोकन context; इनपुट टेक्स्ट, इमेज, वीडियो, ऑडियो (और PDF); आउटपुट टेक्स्ट; लंबे कामों की योजना बनाना और sub-agents को काम बाँटना; ब्राउज़र/डेस्कटॉप "computer use"।
- मुख्य दावा: personal/professional एजेंट, memory और कोडिंग बेंचमार्क पर सर्वश्रेष्ठ – Meta की टेबल में Full SWE-Marathon पर 57.5 (लंबे सॉफ़्टवेयर प्रोजेक्ट) बनाम Opus 5.5 का 46.3, और इंटरनल MemoryBench पर 85.5 बनाम 81.5।
- शर्त: फ़्लैगशिप API पर नहीं; सबसे चौंकाने वाली rows Meta के इंटरनल टेस्ट या बिना-कंट्रोल थर्ड-पार्टी हार्नेस की हैं; इंडिपेंडेंट AA Intelligence Index में अब भी Opus 5.5 पहले (58 बनाम 52) – और Wonder प्रति इंडेक्स-काम $4.52 लेता है बनाम GPT-6.1 Sol के $0.72 (वही 52)।
- किसके लिए: Meta के स्टैक पर लंबे एजेंट/कोडिंग वर्कफ़्लो चलाने वाले डेवलपर, और Muse Code Power/Maximum सब्सक्राइबर। बाकियों के लिए कंज़्यूमर कहानी (Muse ऐप) अभी पूरी तरह शुरू नहीं हुई।
Muse Wonder असल में क्या है
इसे उस सीढ़ी का अगला डग समझें जिसे Meta पूरे साल सार्वजनिक रूप से चढ़ता आया है: Muse Spark (अप्रैल 2026) Superintelligence Labs का पहला मॉडल परिवार था; Muse (सितंबर 2026) ने Spark 1.3 के ऊपर personal एजेंट बैठाया; और Wonder वही "कहीं बड़ी क्लास के मॉडल" हैं जिनका वादा ज़ुकरबर्ग ने बाद में किया था। Meta के AI स्टैक के ज़मीनी रीबूट के 14 महीने बाद, यह पहला रिलीज़ है जिसे लैब खुलकर frontier-class कह रहा है। तकनीकी रूप से यह Spark की pretraining और reinforcement-learning काम पर बना है – वही API सतह, इसलिए Spark 1.3 से Wonder पर जाना मॉडल-ID बदलना है, रीराइट नहीं।
दो मुख्य मैकेनिज़्म अलग-अलग पहचान हैं। Active Memory आपके बारे में अहम बातें बातचीत के पार ले जाती है और मौजूदा काम के लिए ज़रूरी विवरण ख़ुद निकालती है – "एजेंट को याद रहता है" अब डेमो नहीं, बेंचमार्क-की-हुई विशेषता है (MemoryBench: 64K–100K-टोकन मल्टी-टर्न बातचीत, शोर वाली थ्रेड और बाद में पुराने तथ्यों से टकराने वाले सुधार)। Active Focus लगन की विशेषता है: काम अटकने पर दूसरे तरीके आज़माना, सफ़ाई माँगना, और अहम कदम से पहले चेक-इन करना – FocusBench (housing, travel, IT और finance के काम, असली रुकावटों के साथ) और SWE-Marathon पर लगातार चलने के साथ मापा गया।
दोनों पर एक ईमानदारी नोट: ये Meta के इंटरनल बेंचमार्क हैं। MemoryBench और FocusBench का कोई सार्वजनिक लीडरबोर्ड या बाहरी दोहराव अभी नहीं है – इसलिए memory/focus कहानी को "Meta ने क्या मापा" तक सीमित रखें, पक्का साइंस न समझें।
स्पेक्स एक नज़र में
| विशेषता | Muse Wonder / Full | Muse Spark 1.3 (पिछला) |
|---|---|---|
| मॉडल ID | muse-wonder-1.0 (preview); Full की कोई सार्वजनिक ID नहीं | muse-spark-1.3 |
| Context | 1,048,576 टोकन | 1,048,576 टोकन |
| इनपुट → आउटपुट | टेक्स्ट, इमेज, वीडियो, ऑडियो, PDF → टेक्स्ट | टेक्स्ट, इमेज, वीडियो → टेक्स्ट (ऑडियो पूरा समर्थित नहीं) |
| API एक्सेस | Wonder: हाँ। Full: कभी नहीं (सिर्फ़ Muse Code) | हाँ |
| API कीमत (प्रति M टोकन) | $4 इन / $0.20 कैश्ड / $20 आउट | $1.25 इन / $0.15 कैश्ड / $4.25 आउट |
| Weights | प्रोप्राइटरी – कोई open weights घोषित नहीं | Spark Open वेरिएंट: 816B open-weight |
| उपलब्धता | Meta Model API + Muse Code अब; Muse ऐप जल्द (सब्सक्राइबर पहले) | API, Muse और open वेरिएंट |
ईमानदार row है API एक्सेस: Wonder की reasoning effort max पर सेट करने से Full नहीं मिलता – Full सिर्फ़ Muse Code कमांड-लाइन एजेंट से मिलता है। आपकी ऐप जो मॉडल कॉल करती है वह मध्य-स्तर वाला ही है, हमेशा। यह भी ध्यान दें: Wonder एक preview मॉडल ID है; दोहराव की उम्मीद रखें।
कीमत: असल में कितना खर्च
| रास्ता | कीमत | कौन-सा मॉडल | आपके डेटा पर ट्रेनिंग? |
|---|---|---|---|
| Meta Model API | $4 इन / $0.20 कैश्ड / $20 आउट प्रति M टोकन; कोई मिनिमम स्पेंड नहीं | सिर्फ़ Wonder | नहीं – सिर्फ़ Standard मोड |
| Muse Code – Everyday | $5/माह (प्रति 5 घंटे 10–50 प्रॉम्प्ट) | Wonder | Contributor मोड डिफ़ॉल्ट |
| Muse Code – Power | $50/माह | Wonder + Full | Contributor मोड डिफ़ॉल्ट |
| Muse Code – Maximum | $200/माह | Wonder + Full | Contributor मोड डिफ़ॉल्ट |
| Muse ऐप (कंज़्यूमर) | $20 या $100/माह | Wonder "जल्द", सब्सक्राइबर पहले | बातचीत विज्ञापनों में इस्तेमाल नहीं, Meta के अनुसार |
- शर्त/चढ़ाव: बराबर टोकन-दरें बराबर बिल नहीं होतीं। Artificial Analysis के इंडेक्स रन में Wonder प्रति पूरे काम $4.52 लेता है, Opus 5.5 $5.98 (जो छह पॉइंट आगे है) और GPT-6.1 Sol $0.72 (वही 52)। Muse मॉडल सुइट के median से कहीं ज़्यादा आउटपुट टोकन बनाते हैं (130–140M बनाम 85–88M), क्योंकि reasoning और एजेंट-कदम भी आउटपुट में बिल होते हैं। असली आँकड़ा आपका वर्कलोड तय करता है – ख़ुद मापें।
- ठोस उदाहरण: दस-कदम कोडिंग एजेंट जो हर कदम पर ~50K टोकन पढ़ता और ~8K लिखता है, क़रीब 500K इन + 80K आउट प्रति काम बनाता है: Wonder से ~$2.00 + $1.60 ≈ $3.60 – और $0.20/M पर भारी प्रॉम्प्ट कैशिंग बार-बार के इनपुट हिस्से को लगभग ज़ीरो तक घटा देती है। अपने आँकड़े हमारे API cost calculator से निकालें।
- डेटा स्विच: API पर आपका कंटेंट ट्रेनिंग के लिए इस्तेमाल नहीं होता (Standard मोड)। Muse Code सब्सक्रिप्शन डिफ़ॉल्ट रूप से Contributor मोड में हैं – ज़्यादा उपयोग के बदले Meta आपके प्रॉम्प्ट, कोड और फ़ाइलों पर ट्रेन करता है। सेटिंग्स से कभी भी बंद किया जा सकता है; संवेदनशील कोड भेजने से पहले बंद कर दें।
- सीमाएँ: muse-wonder-1.0 पर 3,000 रिक़वेस्ट और प्रति मिनट 4M टोकन की सीमा है – टीम की सारी keys में साझा।
तुलना कैसी है
Meta की अपनी टेबल, हर row पर max reasoning effort (लॉन्च सामग्री से संकलित):
| बेंचमार्क (क्या टेस्ट करता है) | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon (लंबे सॉफ़्टवेयर प्रोजेक्ट) | 57.5 (xhigh) | 53.1 | 46.3 | 42.5 |
| DeepSWE v1.1 (लंबे समय की कोडिंग) | 79.0 | 78.8 | 74.2 | 74.1 |
| Harvey LAB-AA v1.1 (legal agent, सख़्त पास) | 13.1 | 10.0 | 4.2 | 8.6 |
| AutomationBench-AA (बिज़नेस वर्कफ़्लो) | 45.4 | 39.1 | 41.2 | 41.6 |
| ProgramBench (शुरू से प्रोग्राम) | 59.0 | 50.0 | 70.5 | 52.5 |
| Terminal-Bench 4.0 (टर्मिनल कोडिंग) | 57.1 | 52.0 | 59.6 | 59.1 |
| HealthBench Pro (स्वास्थ्य सवाल) | 62.3 | 60.5 | 65.6 | 65.3 |
ईमानदारी से पढ़ें: Full वहीं आगे है जहाँ काम लंबा होता है – कई-दिन के सॉफ़्टवेयर प्रोजेक्ट, सख़्त legal-agent काम (Harvey LAB-AA की hallucination-पर-ज़ीरो ग्रेडिंग: 13.1% सख़्त पास भी टेस्ट किए गए किसी मॉडल की सर्वश्रेष्ठ है), और बिज़नेस वर्कफ़्लो। Opus 5.5 को from-scratch प्रोग्रामिंग, टर्मिनल कोडिंग और स्वास्थ्य सवालों पर बढ़त बनी है; computer use (OSWorld V2.1) भी Meta के चार्टों में Anthropic के मॉडल के पक्ष में है। साधारण Wonder अधिकतर rows पर बीच में खड़ा है।
Meta की मेथडोलॉजी के caveats ज़रूरी हैं: प्रतिस्पर्धी रन "best-effort" हैं, SWE-Marathon कंट्रोल्ड तुलना नहीं (Full xhigh effort पर; Astra और Fable 5.1 की rows Codex और Claude Code रनों से), किसी row में confidence interval नहीं, और जहाँ थर्ड-पार्टी नतीजा मौजूद है Meta वही लेता है – वरना अपने रन, सेल्फ़-रिपोर्ट या आधिकारिक लीडरबोर्ड में से सबसे ऊँचा।
इंडिपेंडेंट तरफ़, Artificial Analysis का Intelligence Index (v4.3.2, लॉन्च डे) ऐसे रैंक करता है: Opus 5.5 58 · Wonder Full 56 · GPT-6 Astra 53 · Gemini 4 Argon 53 · Muse Wonder 52 · GPT-6.1 Sol 52 · Muse Spark 1.3 48। Claire Vo के How I AI बेंच (~20 काम – prototyping, कोडिंग, लेखन, डिज़ाइन) की स्वतंत्र जाँच एजेंट वाले फ़्रेम से सहमत है: Wonder तीन एजेंट कामों पर पहले रैंक पर रहा और one-shot कामों में तेज़ था, पर डिज़ाइन-पक्ष के आउटपुट (SVG चित्रण, छोटे-फ़ॉर्म वीडियो) में Opus 5.5, Astra और Fable से पीछे रहा और लंबे एजेंट कामों में धीमा चला।
सामान्यीकरण की दलील – "benchmaxxing" का Meta का जवाब
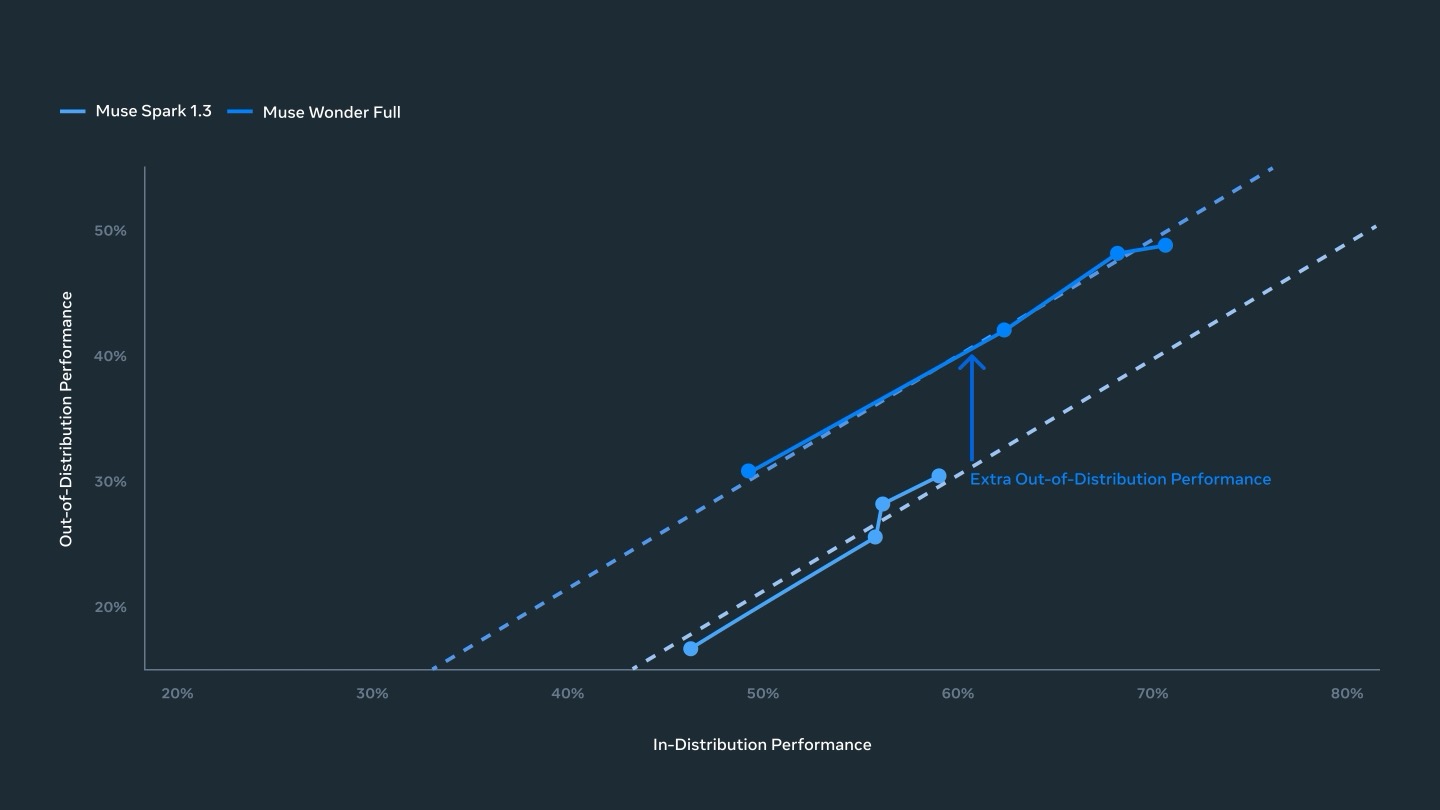
रिसर्च पोस्ट में बेंचमार्क टेबल से कुछ दुर्लभ भी है: स्कोर क्यों माने जाएँ, इसकी दलील। Frontier मॉडलों पर दो इल्ज़ाम लगते हैं – benchmaxxing (जाने-माने टेस्टों पर ओवरफ़िट) और वह जिसे पोस्ट "big model smell" कहती है (स्कोर पैरामीटर-गिनती के पीछे चलना, असली क्षमता नहीं)। Meta का जवाब test-time-compute स्केलिंग विश्लेषण है: Wonder Full Spark 1.3 की OOD (out-of-distribution) ट्रेंड लाइन से ऊपर स्कोर करता है – दावा यह कि फ़ायदा बेहतर ट्रेनिंग से आया, इस साल के टेस्ट रटने से नहीं।
यह ख़ुद-ग्रेडेड दलील उनके ही परिवार के बारे में है – पर यही सही क़िस्म का चार्ट है जो छापना चाहिए, और यह एक परखने-योग्य भविष्यवाणी करता है: Wonder-क्लास परफ़ॉरमेंस अनजान कामों के साथ भी टिकनी चाहिए (आने वाले महीनों में इंडिपेंडेंट बेंच देखिए)।
सेफ़्टी: मॉडल कार्ड असल में क्या बताता है
- मुख्य स्वीकृति: बिना mitigations के Meta यह नहीं निकालता कि Wonder Full अपने Superintelligence Scaling Framework के तहत Chemical & Biological डोमेन की high-risk दहलीज़ छू सकता है। सेफ़्टी post-training और सिस्टम-स्तर के क्लासिफ़ायर के साथ अवशिष्ट जोखिम सभी डोमेन में "moderate या उससे कम" – डिप्लॉय फ़ैसले की नींव।
- साइबर क्षमता: CyberGym 88.4%, ExploitBench 58.9%, और ExploitGym में 92 फ़्लैग – जिनमें Meta ख़ुद बताता है कि सिर्फ़ 21 इरादे वाली कमज़ोरी से मिले (71 अनजाने बगों के ज़रिए)। यह फ़ुटनोट असाधारण ईमानदार है और दो बार पढ़ने लायक़: मॉडल उपयोगी सुरक्षा-टूल भी है और रचनात्मक हमलावर भी।
- रिफ़्यूज़ल मज़बूती: SecureBio के BioTIER पर 98.7% (अंग्रेज़ी), इंटरनल केमिस्ट्री-रिफ़्यूज़ल सेट पर 100%, और CyberBench/PolyGuard पर हमला-सफलता-दर 0.8–2.3% (RedCode पर 9%)। MASK – प्रेशर में ईमानदारी: 87.3%; Agentic Misalignment: 0%।
- प्राइवेसी व्यवहार: Meta के personal-data टेस्टों में Full 2.2% केसों में निजी जानकारी ग़लत सँभालता है (Wonder 3.4%; GPT-6 Astra 4.6%; Fable 5.1 6.8%)। तब यह अहम होता है जब personal एजेंट आपका मेल, कैलेंडर और दस्तावेज़ पढ़ता है।
- अब भी नहीं मिला: पूरी सेफ़्टी रिपोर्ट ("जल्द आ रही"), पैरामीटर-गिनती, और कोई open-weights योजना। मॉडल कार्ड 3D/spatial reasoning को ज्ञात कमज़ोरी बताता है और कहता है कि मॉडल 18 वर्ष से कम उम्र के लिए नहीं है।
भारत-कोण
- एक्सेस: Meta Model API और Muse Code भारत से चलते हैं (बिलिंग USD; INR कीमतें प्रकाशित नहीं)। कंज़्यूमर Muse ऐप सितंबर के लॉन्च से US-only है, इसलिए "personal एजेंट" अनुभव अधिकारिक रूप से अभी यहाँ नहीं – Muse में Wonder पहले सब्सक्राइबरों तक जाएगा, क्षेत्र-योजना घोषित नहीं।
- रुपयों में लागत: Muse Code Power $50/माह ≈ ₹4,300–4,500/माह, Maximum $200 ≈ ₹17,000–18,000/माह (सांकेतिक, ~₹85–88 प्रति डॉलर)। API ख़र्च आपके कार्ड के forex दरों पर USD में मीटर होता है।
- लोकल तुलना: $200/माह एक ठीक-ठाक GPU की EMI है। अगर आपका वर्कलोड ज़्यादा-मात्रा कोडिंग एजेंट है, तो हमारी local-vs-cloud लागत गणित और ₹50,000 से कम GPU गाइड बताती हैं कि एक-बार का रिग कब per-token बिलिंग को हराता है – Wonder की $4/$20 दरें क्लाउड एजेंटों को Spark 1.3 से कहीं महँगा देती हैं।
कौन-सा चुनें
- Wonder चुनें अगर: आप लंबे एजेंट या कोडिंग वर्कफ़्लो चलाते हैं और per-token बिलिंग वाला frontier एजेंट मॉडल चाहते हैं। मल्टी-घंटे के रनों पर प्रोटोटाइप करें जहाँ memory/focus असल में काम आते हैं; ज़्यादा-मात्रा या लेटेंसी-संवेदनशील कदमों के लिए Spark 1.3 रखें – यह Meta की अपनी सलाह है, और 3× टोकन-प्रीमियम इसे समझदारी भरा बनाता है।
- Full चुनें अगर: आपका काम लंबे चलने वाले सॉफ़्टवेयर प्रोजेक्ट हैं और आप पहले से Muse Code Power/Maximum सब्सक्राइबर हैं। काम का कोड भेजने से पहले Contributor मोड बंद करें।
- इसकी जगह: आज सबसे मज़बूत all-rounder चाहिए तो Claude Opus 5.5 (AA इंडेक्स और from-scratch/टर्मिनल/स्वास्थ्य rows में अब भी सबसे आगे); लागत भारी हो तो GPT-6.1 Sol (वही इंडिपेंडेंट स्कोर, $0.72/काम पर); OpenAI विकल्प के रूप में GPT-6 Astra।
लोकल AI चलाने वालों के लिए इसका मतलब
कुछ भी लोकली नहीं आता – Wonder प्रोप्राइटरी है, कोई वेट्स नहीं, कोई क्वांटाइज़्ड बिल्ड नहीं, और मॉडल कार्ड quantization संवेदनशीलता को caveat बताता है, रिलीज़ प्लान नहीं। दिलचस्प संकेत सीढ़ी की बनावट है: Meta एक rung खुला रखता है (Spark Open 816B, Muse Glimmer) जबकि frontier rung बंद रहता है। यहाँ पहली बार दिखने वाली मैकेनिक्स – पार-सेशन memory retrieval, sub-agent delegation, काम से पहले चेक-इन – वही फ़ीचर हैं जिन्हें लोकल और open-source स्टैक अगले दो क्वार्टर नक़ल करेंगे, क्योंकि एजेंट हार्नेस (llama.cpp-आधारित टूल शामिल) इन्हें हार्नेस-परत पर मध्य-आकार मॉडलों से भी बना सकते हैं।
लोकल उपयोगकर्ताओं के लिए व्यावहारिक सबक: यह मानने से पहले कि क्लाउड सस्ता है, अपने एजेंट वर्कलोड की कीमत निकालें। Wonder की दरों पर प्रति काम 500K इनपुट टोकन चबाने वाला कोडिंग एजेंट इस्तेमाल की हुई GPU को अचानक तेज़ी से चुकाता है – हमारी break-even कैलकुलेटर गाइड और local-AI शुरुआती गाइड वे दो बुकमार्क हैं जो तैयार रखने चाहिए।
निचोड़
Muse Wonder, Superintelligence Labs रीबूट के बाद Meta का पहला भरोसेमंद frontier दावा है – और एक्सेस की बनावट बताती है कि Meta बाज़ार को कैसे देखता है: वह मॉडल जिसे आपका कोड कॉल कर सकता है, मध्य-स्तर वाला है और Opus-स्तर की टोकन दरों पर है, जबकि फ़्लैगशिप ऐसे सब्सक्रिप्शन के पीछे है जो डिफ़ॉल्ट रूप से आपके डेटा पर ट्रेन करता है। एजेंट मैकेनिक्स (Active Memory, Active Focus) असली, बेंचमार्क-की-हुई प्रोडक्ट विशेषताएँ हैं – भले ही उनके टेस्ट ख़ुद-ग्रेडेड हैं। अगर आप एजेंट बनाते हैं, अपने वर्कलोड पर आँकड़े निकालिए – क्षमता की छलाँग असली है, और बिल भी।
स्रोत
- Meta AI Research: Muse Wonder – A Frontier Model For Personal & Professional AI Agents (12 अक्टूबर, 2026)
- Meta: Muse Wonder मॉडल कार्ड (evaluation, सेफ़्टी आकलन, सीमाएँ)
- Meta Newsroom: Introducing Muse Wonder and Muse Wonder Full (12 अक्टूबर, 2026)
- Meta Model API docs: Muse Code सब्सक्रिप्शन और मोड
- Artificial Analysis: Muse Wonder के लॉन्च-डे Intelligence Index स्कोर
- Claire Vo (How I AI): स्वतंत्र ~20-काम first-look बेंच (14 अक्टूबर, 2026)
- हमारा Muse personal-agent विस्तार (Spark 1.3, Secure VM, कीमत)
कंटेंट और चित्र नोट: यह VelsTech Solutions का cited स्रोतों का अपना सार और विश्लेषण है – किसी लेख का टेक्स्ट पूरे का पूरा नहीं लिया गया, बेंचमार्क आँकड़े अपने प्रकाशकों को जिम्मेदार हैं (Meta अपनी टेबलों के लिए, Artificial Analysis इंडिपेंडेंट इंडेक्स के लिए), और सभी क्षमता-दावे विक्रेता-रिपोर्टेड हैं जब तक कहा न जाए। चित्र © Meta Platforms, Inc. – संपादकीय कवरेज के लिए, क्रेडिट हर figcaption में रखा गया (यह भी देखें img/muse-wonder/NOTICE.md)। Muse, Muse Wonder, Meta और संबंधित मार्क Meta Platforms, Inc. के ट्रेडमार्क हैं; बाकी नाम अपने-अपने मालिकों के ट्रेडमार्क हैं।
FAQ
Muse Wonder क्या है?
Muse Wonder Meta Superintelligence Labs का personal और professional एजेंटों के लिए frontier मॉडल परिवार है, रिलीज़ 12 अक्टूबर, 2026। दो स्तर – Muse Wonder (मॉडल ID muse-wonder-1.0, preview) और ज़्यादा ताक़तवर Muse Wonder Full – जो Muse Spark 1.3 की सीढ़ी पर अगला डग हैं। 1 मिलियन-टोकन context, इनपुट में टेक्स्ट/इमेज/वीडियो/ऑडियो, आउटपुट टेक्स्ट, ट्रेनिंग Meta के Prometheus डेटासेंटर में। पहचान: Active Memory (बातचीत के पार संदर्भ ले जाना और निकालना) और Active Focus (रुकावटों से आगे बढ़ना, सफ़ाई माँगना, चेक-इन)।
Muse Wonder की कीमत कितनी है?
Meta Model API पर: $4 प्रति मिलियन इनपुट टोकन, $0.20 कैश्ड इनपुट, $20 प्रति मिलियन आउटपुट – Claude Opus 5.5 जितनी दरें, कोई मिनिमम स्पेंड नहीं। Muse Code प्लान: $5 (Everyday, Wonder शामिल), $50 (Power) और $200 (Maximum) मासिक; Wonder Full सिर्फ़ $50 और $200 टियरों पर। Muse कंज़्यूमर ऐप $20 या $100 मासिक है, Wonder पहले सब्सक्राइबरों तक पहुँचेगा।
Muse Wonder और Muse Wonder Full में फ़र्क़ क्या है?
एक्सेस और क्षमता। Wonder API से कॉल होता है और हर Muse Code प्लान पर है; Full सिर्फ़ Muse Code के $50/$200 प्लानों में है और API से बिल्कुल नहीं मिलता। Meta के टेस्टों में Full लंबे सॉफ़्टवेयर प्रोजेक्ट (SWE-Marathon 57.5 बनाम 53.1), सख़्त legal-agent काम (Harvey LAB-AA 13.1 बनाम 10.0) और बिज़नेस वर्कफ़्लो (45.4 बनाम 39.1) पर आगे है; साधारण Wonder from-scratch प्रोग्रामिंग (50.0 बनाम 70.5), टर्मिनल कोडिंग (52.0 बनाम 59.6) और स्वास्थ्य सवालों (60.5 बनाम 65.6) में Opus 5.5 से पीछे है। इंडिपेंडेंट (Artificial Analysis): Full 56, Wonder 52, Opus 5.5 58।
Active Memory और Active Focus क्या हैं?
Active Memory आपके बारे में अहम संदर्भ बातचीत के पार ले जाती और हर काम के लिए ज़रूरी विवरण निकालती है; Meta के इंटरनल MemoryBench (64K–100K-टोकन बातचीत, शोर और सुधारों के साथ) पर Wonder 85.6 और Full 85.5 बनाम Opus 5.5 का 81.5 और GPT-6 Astra का 81.4। Active Focus लगातार लक्ष्य-पीछा है – अटकने पर दूसरे तरीके, सफ़ाई, अहम कदम से पहले चेक-इन; FocusBench पर Full 54.2% बनाम Astra 47.7%, Opus 5.5 45.8% और Wonder 44.9%। दोनों बेंचमार्क Meta के इंटरनल हैं, अभी स्वतंत्र रूप से दोहराए नहीं गए।
क्या Meta मेरे डेटा पर ट्रेन करता है?
रास्ते पर निर्भर करता है। Meta Model API Wonder को सिर्फ़ Standard मोड में चलाता है, जहाँ Meta के अनुसार आपका कंटेंट ट्रेनिंग में इस्तेमाल नहीं होता। Muse Code सब्सक्रिप्शन – Wonder Full तक पहुँच का इकलौता रास्ता – डिफ़ॉल्ट रूप से Contributor मोड में होते हैं: ज़्यादा उपयोग के बदले Meta आपके प्रॉम्प्ट, कोड और फ़ाइलों पर ट्रेन करता है। सेटिंग्स से कभी भी बंद किया जा सकता है – प्रोप्राइटरी कोड से पहले बंद करना उचित है।
क्या Muse Wonder लोकली चल सकता है या भारत से इस्तेमाल हो?
लोकली नहीं – वेट्स प्रोप्राइटरी हैं और कोई open रिलीज़ घोषित नहीं (Meta के खुले rung: Muse Spark Open 816B और Muse Glimmer 30B)। भारत से Meta Model API और Muse Code इस्तेमाल हो सकते हैं (USD बिलिंग), जबकि कंज़्यूमर Muse ऐप लॉन्च के समय US-only है। Muse Code के $50/$200 प्लान लगभग ₹4,400 और ₹17,500 मासिक (सांकेतिक) बैठते हैं।